RT @JafarNajafov: TRANSLASATION: So beschleunigst du deine LLM um das 3- bis 10-fache! (100% Open-Source) Es heißt LMCache. Eine KV-Cache-Schicht, die wiederverwendbare Texte über GPU, CPU, Festplatte und sogar S3 speichert und sie dann in jeder vLLM- oder SGLang-Instanz wiederverwendet. Nicht nur Prefix-Caching. Jeder wiederverwendbare Text, überall im Prompt, auf jedem Knoten. In Kombination mit vLLM erzielen Teams eine 3- bis 10-fach niedrigere TTFT und massive Einsparungen bei GPU-Zyklen bei Multi-Round-QA- und RAG-Workloads. Bereits von Google Cloud, CoreWeave, GMI Cloud, Redis, Weka und NVIDIA Dynamo übernommen. Unter der Apache 2.0-Lizenz. Installation in einer Zeile: pip install lmcache Die Inferenz wird bald viel günstiger. https://github.com/LMCache/LMCache mehr auf Arint.info #AI #GPU #Inference #LLM #LMCache #OpenSource #arint_info https://x.com/JafarNajafov/status/2078065111584186865#m
Related
Neurosymbolic AI by Volodymyr Pavlyshyn is the featured bundle of ebooks 📚 on Leanpub!Link: https://leanpub.com/b/neuros...
Neurosymbolic AI by Volodymyr Pavlyshyn is the featured bundle of ebooks 📚 on Leanpub!Link: https://leanpub.com/b/neurosymbolicai#Harness_engineering_1 #Ai #Prolog #Software_archit...
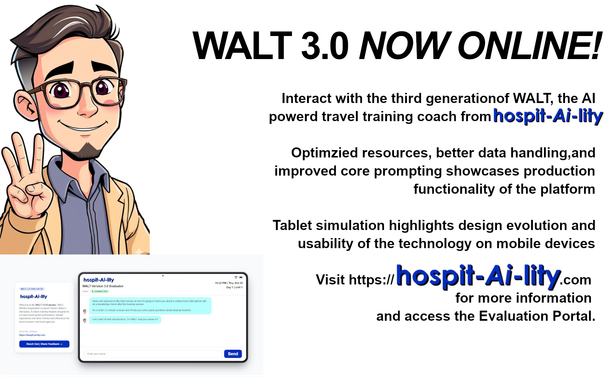
WALT 3.0 NOW ONLINE! We've made upgrades and updates to WALT, our AI powered coach for the hospit-AI-lity travel trainin...
WALT 3.0 NOW ONLINE! We've made upgrades and updates to WALT, our AI powered coach for the hospit-AI-lity travel training platform. Meet and interact with the third generation of W...
I must confess to using LLMs for 3 years (BTW I don't use it for a half year now).I'm very sorry cuz I've contributed to...
I must confess to using LLMs for 3 years (BTW I don't use it for a half year now).I'm very sorry cuz I've contributed to:rising hardware pricesAI slop in art and techdeskillingdisr...