RT @ornith_: Aloha! 🌺 Wir stellen Ornith-1.5 vor, eine Familie von Open-Source-LLMs mit 9B Dense, 35B MoE und 397B MoE, trainiert mit selbstverbessernden Strategien. Es erreicht state-of-the-art Performance unter Open-Source-Modellen vergleichbarer Größe und liefert Leistung vergleichbar mit Claude Opus 4.8 bei Reasoning, agentic und Coding-Aufgaben: ✅Terminal-Bench 2.1 (86.1) ✅SWE-Bench (86 auf verified, 65.1 auf pro, 79.6 auf Multilingual) ✅DeepSWE (56) ✅HLE (44.6) ✅ClawEval (81.4) ✅Tool Decathlon (71.2) Ornith-1.5 macht einen großen Schritt hin zum Training von Foundation Models durch end-to-end Selbstverbesserung und erweitert die in Ornith-1.0 eingeführten Self-Scaffolding-Strategien zu einem vollständigeren Selbstverbesserungs-Loop: Das Modell schlägt neue Aufgaben vor, generiert aufgaben-spezifische Scaffolds und erzeugt Solution Rollouts für Reinforcement Learning, wodurch es kontinuierlich neue Lernerfahrungen schafft, aus denen es sich verbessern kann. Alle Modelle sowie ihre...
Related
Hot Inflation Tests Bitcoin While…https://crypt0snews.com/news/2026-11-11-hot-inflation-tests-bitcoin-while-banks-buy-th...
Hot Inflation Tests Bitcoin While…https://crypt0snews.com/news/2026-11-11-hot-inflation-tests-bitcoin-while-banks-buy-the-dip-and-toke.html?src=mastodon&slot=financeRobots Learn to...
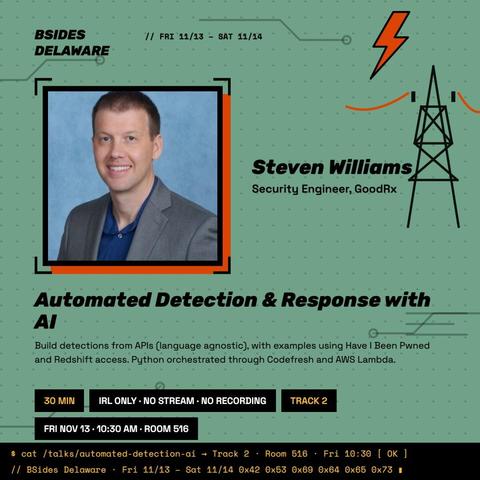
Can AI take an alert all the way to a response? Come see what works, and where you still want a human in the loop. #SOC ...
Can AI take an alert all the way to a response? Come see what works, and where you still want a human in the loop. #SOC #AI #BSidesDE https://events.humanitix.com/security-bsides-d...
NVIDIA down about 12% pre-open … also dragging a few other linked stocks with them. “Jensen Huang resigns as Nvidia CEO”...
NVIDIA down about 12% pre-open … also dragging a few other linked stocks with them. “Jensen Huang resigns as Nvidia CEO”https://www.breakingthenews.net/Article/Jensen-Huang-resigns...