Google Cloud integriert TPU-Support nativ in vLLM für Embedding-Inferenz. Das ermöglicht elastisches Scaling von Pipelines mit 15K+ Token Kontexten auf GKE.https://developers.googleblog.com/enterprise-grade-precision-for-long-context-multimodal-embedding-inference-on-cloud-tpu/#KI #AI #LLM #AISyndicate
Related
Why iFixit's Steam Machine Guides Expose the Parts GapValve gave iFixit the schematics for its Steam Machine but not the...
Why iFixit's Steam Machine Guides Expose the Parts GapValve gave iFixit the schematics for its Steam Machine but not the spare parts. That gap is the whole repair fight.https://vau...
#FLTK is now slopware, so you can stay at 1.4.5x branch or try Mobilized #Dillo compiled against the Fox toolkit.https:/...
#FLTK is now slopware, so you can stay at 1.4.5x branch or try Mobilized #Dillo compiled against the Fox toolkit.https://www.toomanyatoms.com/software/mobilized_dillo.html#ai #slop...
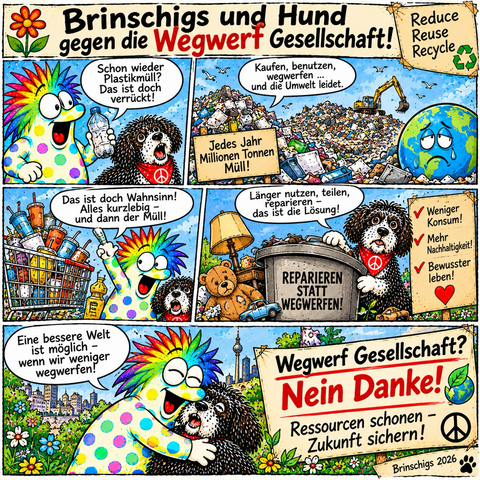
Brinschigs in der Welt *164Comics gebaut mit Brinschigs und #AIund jetzt auch mit meinem HundBy Meister Jeder, Dadaist u...
Brinschigs in der Welt *164Comics gebaut mit Brinschigs und #AIund jetzt auch mit meinem HundBy Meister Jeder, Dadaist und Brinschigmaler 11/26#dada #Brinschig #Comic #AIdada #Brin...