Как мы научили ИИ читать корпоративные регламенты: от наивного RAG до измеримого pipelineВ статье - практический кейс создания корпоративного RAG-сервиса для поиска по внутренним регламентным и нормативным документам. Мы прошли путь от стандартного пайплайна на n8n и Qdrant до гибридной архитектуры с BM25, embeddings, RRF, reranking, структурным chunking и обработкой сложных таблиц и документов. Отдельно разбирается, почему обычная нарезка текста плохо работает на нормативных документах, как мы использовали Natasha, словари корпоративных терминов и мультимодальные модели, а также как построили систему измерения качества через Arize Phoenix и LLM-as-a-Judge. Показаны реальные результаты A/B-теста с реранкером по 9 метрикам с объяснением, почему в production-RAG важнее не «самая умная LLM», а качество подготовки документов, retrieval и воспроизводимая оценка изменений.https://habr.com/ru/articles/1079414/#RAG #RetrievalAugmented_Generation #LLM #корпоративный_поиск #гибридный_поиск #sema...
Related
MiniMax has open-weighted H3-Image, a 33.1 billion parameter diffusion transformer for text-to-image and editing, produc...
MiniMax has open-weighted H3-Image, a 33.1 billion parameter diffusion transformer for text-to-image and editing, producing roughly 16 megapixel output at 4096 by 4096 in under 10 ...
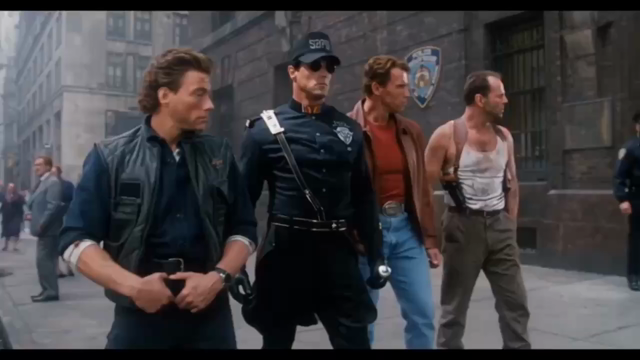
All the heroes.Credit to the creator.#heroes #ai
All the heroes.Credit to the creator.#heroes #ai
AI-Powered Analysis Reveals Hidden Phishing Chains in PDF Attackshttps://www.dwc.news/posts/ai-powered-analysis-reveals-...
AI-Powered Analysis Reveals Hidden Phishing Chains in PDF Attackshttps://www.dwc.news/posts/ai-powered-analysis-reveals-hidden-phishing-chains-in-pdf-attacks-261111#phishing #AI #S...