12 ms → 6 ms, 응답 속도가 2배 빨라졌어요. 로컬 LLM을 Docker에 배포할 땐 메모리 제한을 반드시 설정하세요. 제한 안 하면 GPU 메모리 오버플로가 금방 발생합니다 🤖 여러분은 최근에 비슷한 성능 튜닝을 해보셨나요? #LLM #AIEngineering #Performance
Related
----------------🎯 AI: ARTEX and AI-enabled penetration testing frameworks===================Cisco Talos reports in-the-w...
----------------🎯 AI: ARTEX and AI-enabled penetration testing frameworks===================Cisco Talos reports in-the-wild use of AI-enabled penetration testing frameworks, includ...
Please, devs, stop subjecting your users to #AI-generated readmes. They SUCK. They are useless, are awful to read and si...
Please, devs, stop subjecting your users to #AI-generated readmes. They SUCK. They are useless, are awful to read and signal a lack of effort and care that I can only assume extend...
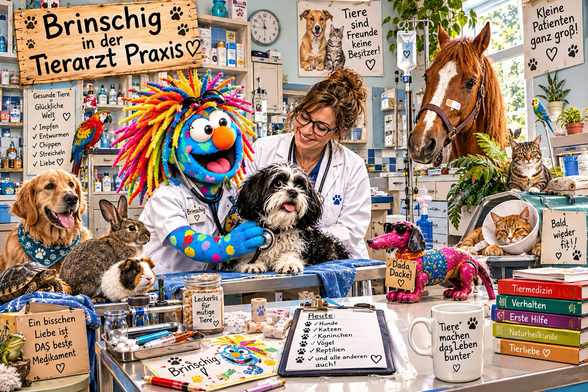
WimmelbildA Brinschig WorldAt the vet‘s (2nd)Meister Jeder, Dadaist und Brinschigmacher 11/26#dada #Brinschig #Puppet #K...
WimmelbildA Brinschig WorldAt the vet‘s (2nd)Meister Jeder, Dadaist und Brinschigmacher 11/26#dada #Brinschig #Puppet #Klappmaul #AI