Механизмы внимания в современных LLMПочему современные LLM больше не используют один «обычный» Attention? Разбираем эволюцию механизмов внимания: MHA, GQA, MLA, local и sparse attention, linear/recurrent подходы и гибридные архитектуры вроде Qwen3.8 и DeepSeek. Смотрим, что происходит с KV‑cache, почему длинный контекст так дорого обходится и как современные модели пытаются совместить качество retrieval с быстрым inference.https://habr.com/ru/articles/1090978/#LLM #attention #GQA #MLA #sparse_attention #linear_attention #KVcache #Qwen #DeepSeek #inference
Related
RE: https://social.lansky.name/@hn50/117641046063643892#AI bias.A white person holding a bag of Doritos is classified as...
RE: https://social.lansky.name/@hn50/117641046063643892#AI bias.A white person holding a bag of Doritos is classified as a person consuming tortilla chips.A black person holding a ...
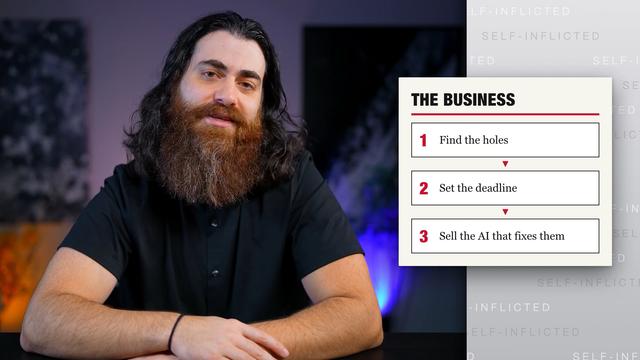
🤔🤔🤔 #AI #Anthropic (Source)
🤔🤔🤔 #AI #Anthropic (Source)
@andiwaffeln I suppose sadly that'd be fitting, given the #Linux #kernel seems to also be aspiring to be filled with #AI...
@andiwaffeln I suppose sadly that'd be fitting, given the #Linux #kernel seems to also be aspiring to be filled with #AI #LLM #code for some reason... 💔 #FreeSoftware #FOSS #FLOSS ...